Diseño de un sistema de reservas de habitación estilo Booking.com
Cómo diseñé y construí un sistema de reservas de hotel con microservicios: inventario consistente, holds de pago, outbox y el problema de la última habitación.

En este artículo voy a explicar el diseño de un sistema basado en microservicios cuyo objetivo principal es el de poder reservar habitaciones de hotel como se hace en booking.com. Considero que este diseño es interesante ya que no es un simple CRUD, porque se tienen que manejar casos especiales donde un CRUD normal falla, como por ejemplo cuando queda una única habitación disponible en temporada alta y más de una persona intenta realizar la reserva de esa misma habitación. Este problema genera cargos duplicados en la tarjeta por una misma habitación, por lo cual tienes que lidiar con devoluciones y clientes molestos.
Un sistema de reservas necesita tener la capacidad de manejar la concurrencia durante cargas altas, mantener la información de forma consistente y debe estar diseñado para tolerar fallos.
El alcance
Para empezar el diseño es importante definir algunas cosas:
- ¿Se van a procesar pagos?
- Vías de reserva: ¿solo web o también versión móvil? ¿Vamos a aceptar reservas desde sistemas externos?
- ¿Aceptaremos cancelaciones y tendremos overbooking?
- ¿Tendremos precios dinámicos?
En nuestro caso vamos a implementar Stripe para procesar pagos. Tendremos una versión web únicamente: toda la gestión de reservas se realizará desde nuestro backend, que será llamado desde una web. Aceptaremos cancelaciones pero no vamos a aceptar overbooking, y para simplificar el proyecto las habitaciones tendrán un precio fijo.
Una última aclaración sobre el alcance: el inventario lo carga un administrador desde un panel, no hay propietarios que publiquen sus propios alojamientos. Un marketplace de dos lados implica pagos salientes, verificación de identidad y comisiones, y eso es un proyecto distinto al que me interesa aquí.
Requerimientos funcionales
Con el alcance definido, podemos pasar a los requerimientos funcionales, es decir, qué tiene que poder hacer el sistema.
- Gestión del catálogo e inventario. Un administrador puede dar de alta hoteles y tipos de habitación, y cargar cuántas unidades hay disponibles.
- Búsqueda. El usuario busca hoteles filtrando por ubicación, fechas de entrada y salida, número de huéspedes y precio. Al ser la operación más frecuente del sistema tiene que responder rápido, y más adelante explico cómo se consigue sin castigar la base de datos donde se escriben las reservas.
- Flujo de reserva. El usuario puede reservar una habitación para unas fechas, consultar sus reservas y cancelarlas. El sistema debe evitar que dos usuarios acaben reservando la misma habitación.
- Pagos. Se integra Stripe como pasarela de pago. El cobro ocurre dentro del flujo de reserva y su resultado determina si la reserva se confirma o se descarta.
- Notificaciones. El usuario recibe confirmación de su reserva, y aviso cuando se cancela o se reembolsa. Es la parte del sistema que puede fallar o retrasarse sin afectar a la reserva en sí.
Requerimientos no funcionales
Definido qué tiene que hacer el sistema, toca definir cómo tiene que comportarse. Estos son los requerimientos no funcionales.
- Consistencia fuerte en el inventario. La regla que no se puede romper nunca es que las unidades reservadas de un tipo de habitación en una fecha no superen las unidades disponibles. El resto de los datos del sistema pueden estar unos segundos desactualizados sin que pase nada.
- Alta concurrencia. El sistema debe ser capaz de recibir una gran cantidad de usuarios intentando reservar de forma simultánea, incluso cuando todos compiten por la misma habitación. El objetivo concreto que me propongo es que doscientas peticiones simultáneas sobre la última unidad disponible terminen en una sola reserva.
- Baja latencia. Que las búsquedas tarden aproximadamente 500 ms, mientras que la gestión de reserva tarde entre 2 y 3 segundos.
- Alta disponibilidad. Al menos un 99,9%.
- Escalabilidad horizontal. El sistema debe poder escalar según el tráfico que esté recibiendo, y sobre todo debe seguir siendo correcto al hacerlo: levantar una segunda instancia del servicio de reservas no puede abrir la puerta a una doble reserva.
Estimación de uso
Para dimensionar el sistema parto de datos reales. Según el informe anual de Booking Holdings, en 2025 se reservaron 1.235 millones de noches en sus plataformas, lo cual me da una base para hacer cálculos.
Asumiendo que una reserva en promedio es de 2 noches y que el año tiene 365 días entonces:
1.235M noches ÷ 2 = 617,5 millones de reservas al año
617,5M ÷ 365 días = 1,7 millones de reservas al día
617,5M ÷ 31.536.000 segundos = ~20 reservas por segundo de media
Teniendo estos números podemos entender que no todas las personas que entran al sistema realizan una reserva: muchos solo entran, revisan precios, y más adelante vuelven a revisarlos hasta que se deciden a reservar o simplemente no hacen nada, por lo tanto hay que diseñar el sistema para que soporte esto también.
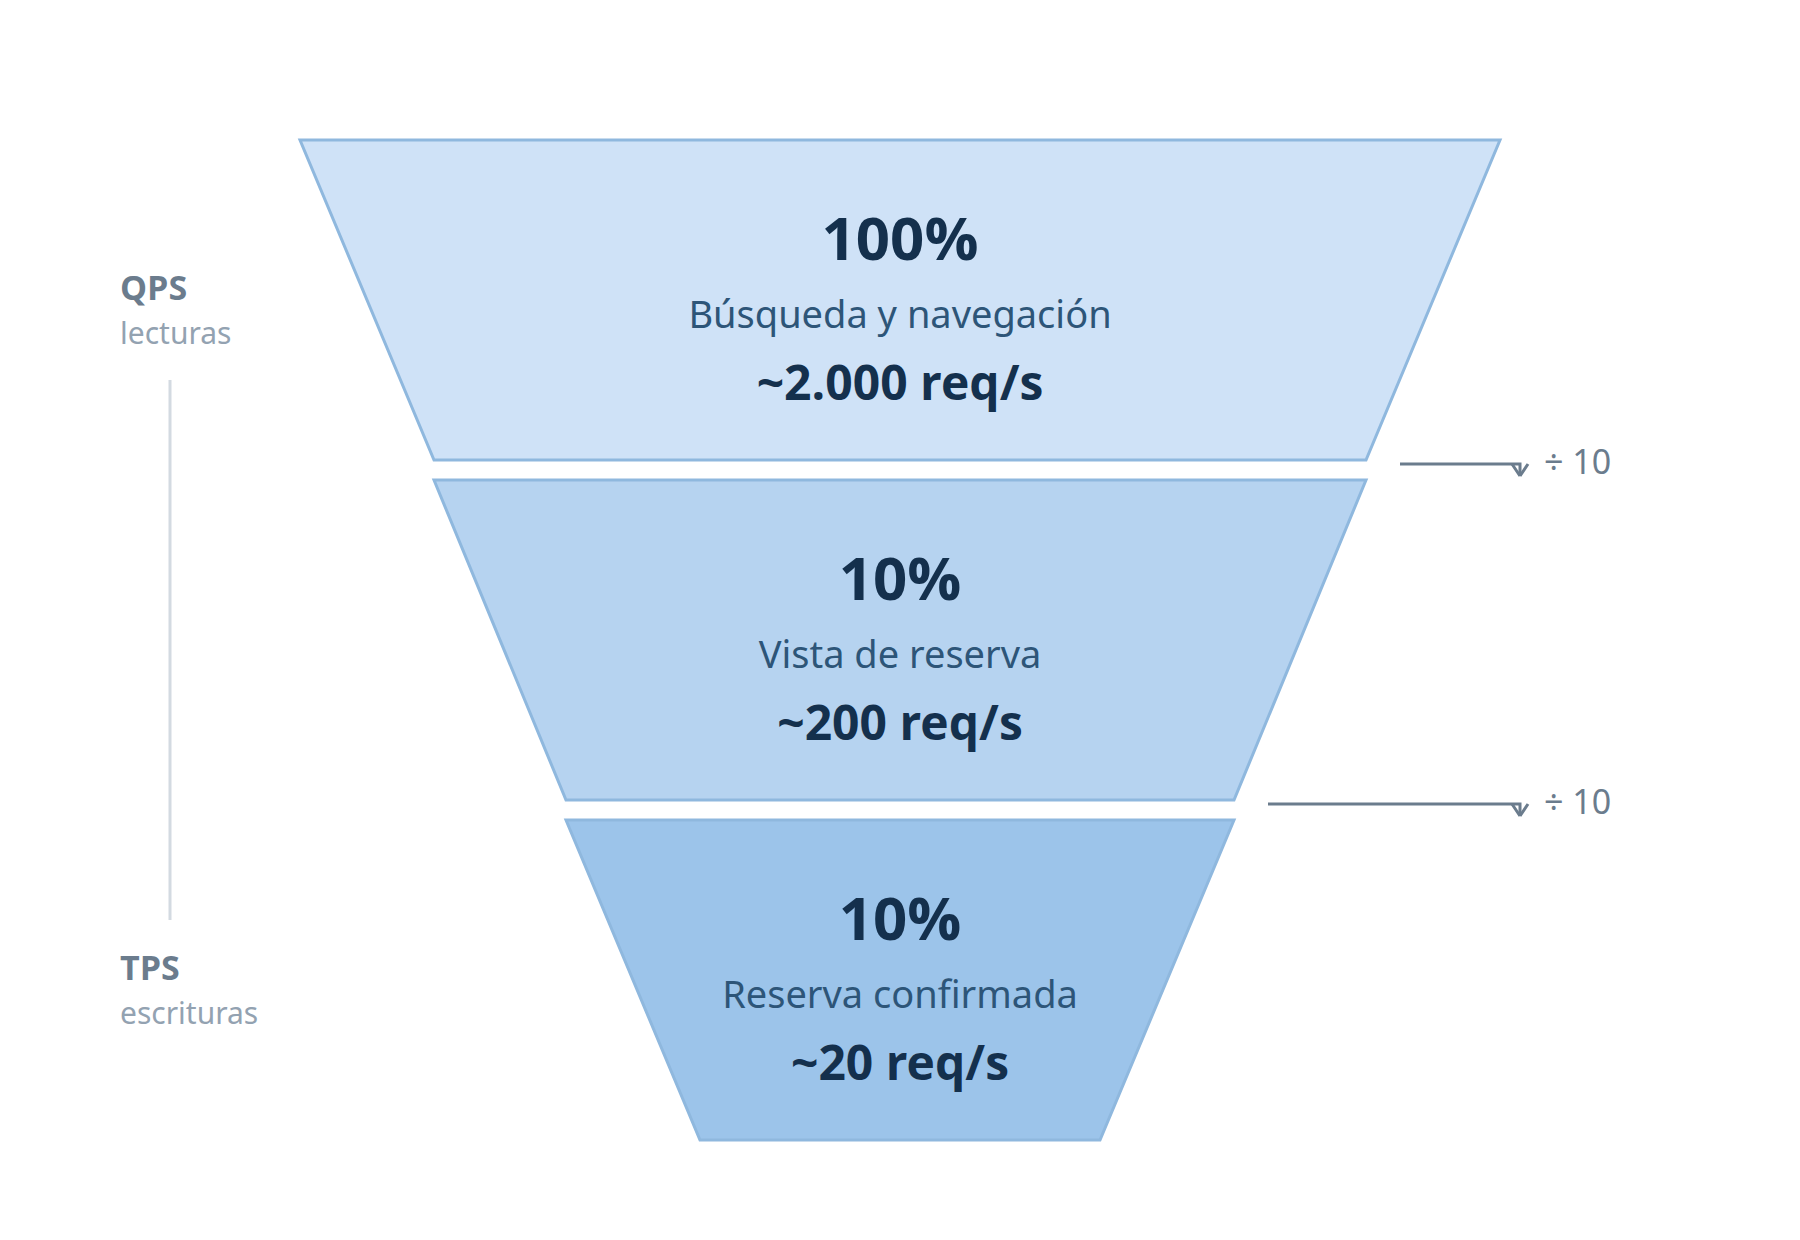
Con este embudo quiero mostrar cómo se distribuye el tráfico. Asumiendo una conversión del 10% en cada paso, del 100% del tráfico solo un 10% llega a la vista de reserva de habitación, y de este último porcentaje sólo un 10% realiza la reserva real, si seguimos estos porcentajes podemos determinar:
Si tenemos 20 requests por segundo para realizar una reserva entonces tendremos 200 request al momento de visualizar la vista de reservar una habitación.
Si 200 request por segundo es el 10% del total entonces tenemos que la aplicación en su totalidad estaría recibiendo 2000 requests por segundo.
Basado en estos números podemos concluir que vamos a tener 20 TPS y 2000 QPS, con lo que tenemos un sistema en el cual la carga es mucho mayor al momento de la lectura que de la escritura, por lo tanto la arquitectura debe estar optimizada para lectura. Pero hay una diferencia importante entre ambas: las lecturas son muchas pero pueden estar unos segundos desactualizadas sin que pase nada, si un usuario ve una habitación que se acaba de reservar simplemente lo va a descubrir al intentar reservarla. Las escrituras en cambio son pocas pero tienen que ser consistentes siempre, porque de ellas depende que no se generen dobles reservas.
Los microservicios
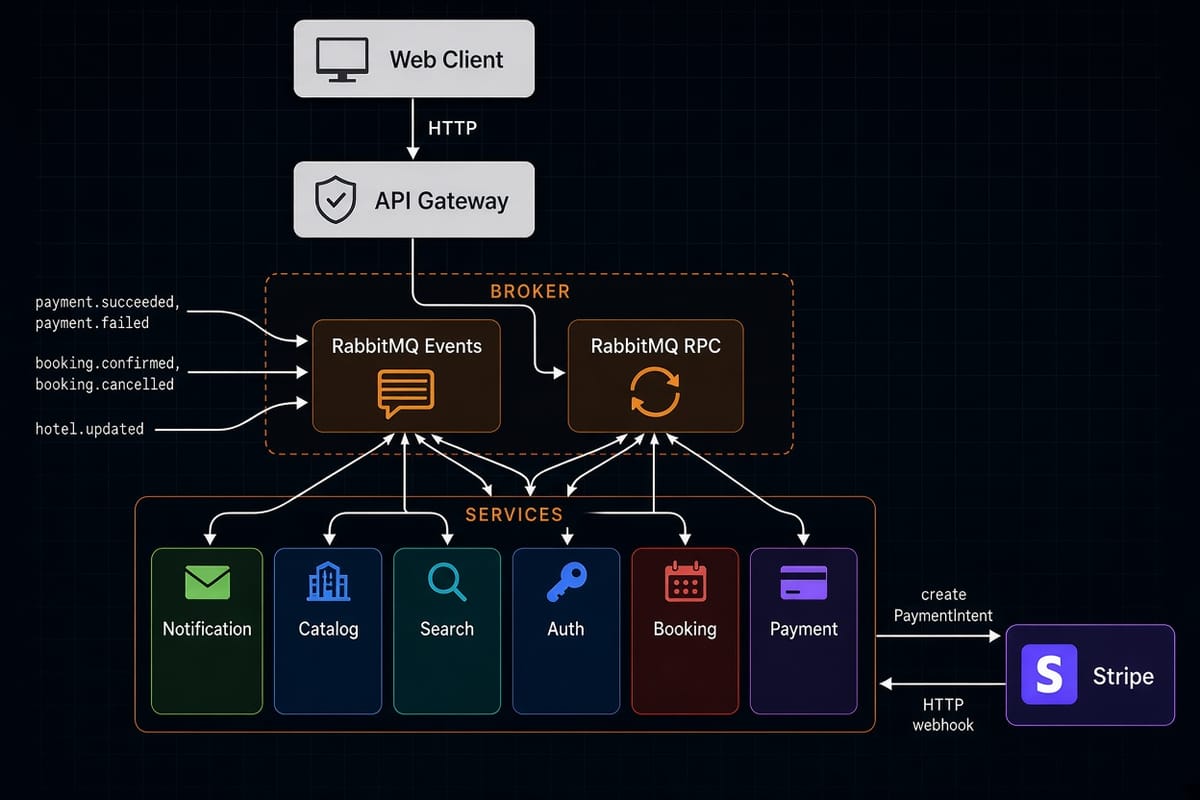
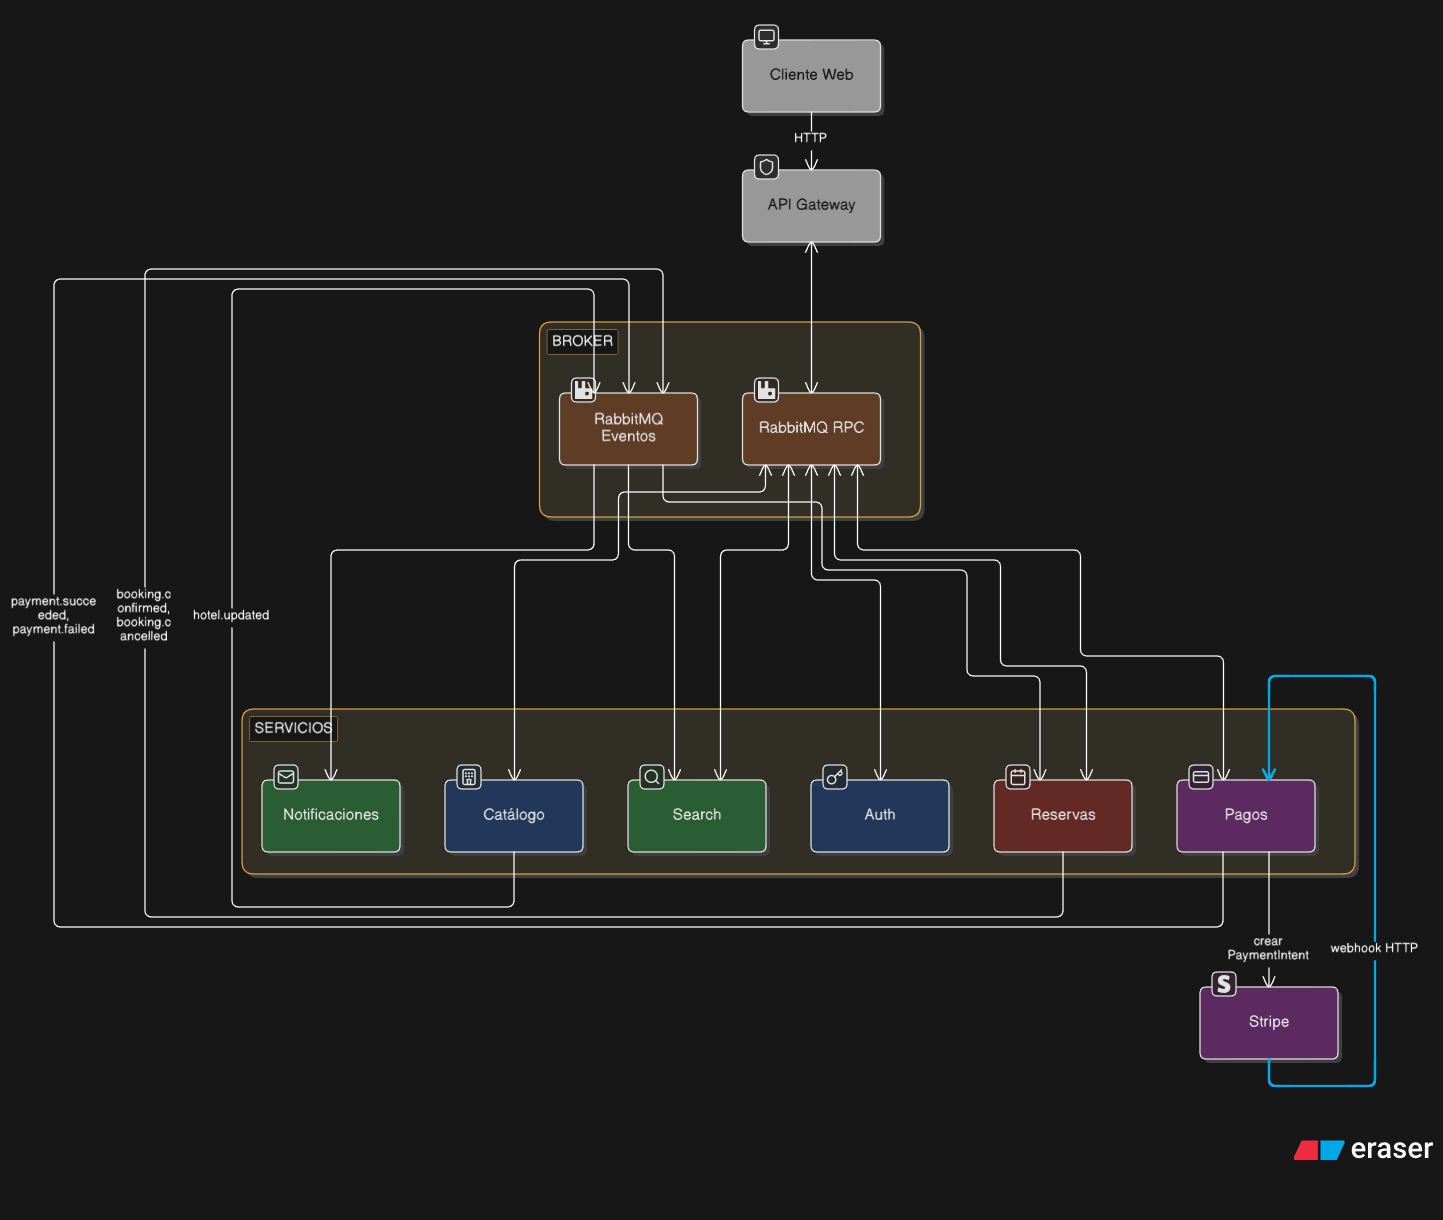
Teniendo en cuenta esto podemos empezar a diseñar el sistema. Para este proyecto utilizo NestJS como framework, y los servicios que voy a construir son siete: seis microservicios y el api gateway, que no cuento como microservicio porque no tiene un dominio propio ni base de datos.
1. Api gateway. Esta será la puerta de entrada del sistema, todas las peticiones del navegador pasarán por el api gateway y este se comunicará con el respectivo microservicio. No tendrá ninguna conexión a una base de datos, solo estará conectado a RabbitMQ para enviar los mensajes a los respectivos microservicios. Aquí no se procesará lógica de negocio, únicamente se validará el token, se comprobará el rol del usuario y se decidirá a qué microservicio enviar cada petición.
2. Auth. Este microservicio se encargará de la gestión de los usuarios, no hará nada más: permitirá registrar y autenticar usuarios, y emitirá el token con el rol correspondiente. Es importante entender que Auth no autoriza cada acción del usuario, solo firma el token al inicio de la sesión; la autorización se hace en dos sitios distintos, el api gateway comprueba el rol y cada microservicio comprueba que el usuario sea el dueño del recurso que está intentando modificar.
3. Catalog. Es el microservicio responsable de administrar la información descriptiva de los hoteles: nombre, ciudad, ubicación, fotos, amenidades, tipos de habitación y precios. Es importante aclarar que el inventario no vive aquí, esa información pertenece al microservicio de booking por motivos que explico más adelante. Este servicio es el origen de los datos de otros dos: ni search ni booking consultan su base de datos, sino que cada vez que un hotel cambia catalog emite un evento con el estado completo del hotel, y a partir de ahí cada uno actualiza su propia copia. Enviar el hotel entero en lugar de solo lo que cambió es más tráfico, pero permite que un consumidor se reconstruya sin necesitar saber nada de la historia previa.
4. Booking. Este es el microservicio central del sistema y es dueño del inventario, de las reservas temporales y de las reservas confirmadas. Estas tres cosas van juntas porque comparten una regla que debe cumplirse siempre y de forma inmediata: las unidades reservadas de un tipo de habitación en una fecha nunca pueden superar las unidades disponibles. Una regla de este tipo no puede repartirse entre varios microservicios, porque entonces haría falta coordinación distribuida para protegerla; estando todo en la misma base de datos se resuelve con una transacción local.
5. Payment. Tal y como dice el nombre se comunica con la plataforma de pagos. Cuando Stripe confirma el cobro, este microservicio no llama directamente a booking sino que emite un evento que booking consume para confirmar la reserva. La única excepción de todo el sistema está aquí: el webhook de Stripe llega por HTTP y además ni siquiera pasa por el api gateway, va directo a payment. El motivo es que Stripe firma los bytes exactos del cuerpo de la petición para que puedas verificar que el mensaje es suyo, y cualquier cosa que lo reserialice por el camino rompería esa firma. Por eso payment es el único microservicio con un servidor HTTP propio expuesto, y solo para esa ruta.
6. Search. Es el microservicio encargado de realizar las búsquedas del sistema, y ni siquiera tiene base de datos propia: su estado vive entero en el motor de búsqueda. No consulta la base de datos de ningún otro microservicio, sino que mantiene su propio índice actualizándolo a partir de los eventos que emite el catálogo, y de esta forma puede responder rápido sin que las búsquedas toquen la base de datos donde se escriben las reservas.
7. Notification. Es el microservicio encargado de enviar notificaciones al usuario. En este caso son solo correos, en concreto dos: la confirmación de una reserva y el aviso de un reembolso, pero si hubiera una aplicación móvil podría enviar notificaciones push. Es el único microservicio que no tiene API: nadie le pide nada ni espera su respuesta, únicamente escucha los eventos del sistema y actúa.
Servicios de apoyo
Definidos los microservicios, toca ver qué servicios de apoyo utilizo y por qué.
1. PostgreSQL. Será la fuente de verdad del sistema y cada microservicio tendrá su propia base de datos, ningún microservicio podrá consultar la base de datos de otro. Lo elijo porque es donde se va a garantizar que no existan dobles reservas, gracias a que puedo usar transacciones y restricciones que la propia base de datos se encarga de hacer cumplir aunque haya varias instancias del microservicio corriendo a la vez.
2. RabbitMQ. Será el encargado de toda la comunicación interna del sistema y lo voy a usar de dos formas distintas. Por un lado el api gateway le envía un mensaje al microservicio correspondiente y se queda esperando la respuesta, porque hay un usuario esperando del otro lado. Y por otro lado los microservicios emiten eventos para avisar de que algo ocurrió, sin esperar respuesta de nadie, como por ejemplo cuando se confirma una reserva y hay que enviar el correo y actualizar el índice de búsqueda.
3. Redis. Lo utilizo como caché en un solo sitio: la ficha pública de un hotel, que es la consulta más cara del catálogo porque junta ciudad, amenidades, tipos de habitación y fotos, y también la más leída, porque cada visita al detalle la pide. Se guarda diez minutos y se invalida explícitamente cuando el hotel cambia. Deliberadamente no cacheo la disponibilidad por fechas, porque es justo el dato que no puede estar desactualizado. Y hay una decisión que me parece más importante que la caché en sí: si Redis no está disponible, todas sus operaciones se comportan como un fallo de caché y la consulta va a Postgres. Una caché nunca debería ser un punto único de fallo, y así el servicio sigue funcionando aunque Redis se caiga.
4. Elasticsearch. Es el motor de búsqueda del sistema. Lo necesito porque las búsquedas del usuario no son simples filtros: hay que buscar por nombre de hotel o de ciudad tolerando errores de escritura, ordenar por relevancia y filtrar por varios criterios a la vez. Con un catálogo que mezcla ciudades españolas, francesas y alemanas, que buscar «munich» encuentre «Múnich» no es un lujo. Además me permite separar la carga de lectura de la base de datos donde se escriben las reservas, y reconstruir el índice entero sin que las búsquedas dejen de contestar: el código nunca escribe contra un índice con nombre fijo sino contra un alias, así que se construye el índice nuevo en paralelo y el cambio es una sola operación atómica al final.
El problema de la última habitación
Con todas las piezas definidas, toca resolver el problema del que partí: varias personas reservando la última habitación a la vez.
Lo primero es entender por qué falla la solución que parece obvia. Lo natural sería consultar cuántas unidades quedan, comprobar en el código que haya disponibilidad y luego guardar la reserva, es decir, un SELECT para ver el inventario, un if para comprobar que hay sitio y un INSERT para crear la reserva. El problema es que entre la consulta y la escritura hay un espacio de tiempo, y en ese espacio pueden entrar otras peticiones. Si doscientas personas consultan a la vez, las doscientas van a leer que queda una habitación disponible, las doscientas van a pasar la comprobación y las doscientas van a insertar su reserva. El código está bien escrito, la lógica parece correcta, y aun así el sistema vende la misma habitación doscientas veces.
Antes de poder proteger la disponibilidad hay que decidir cómo se representa, porque esa decisión determina qué herramientas voy a tener disponibles para protegerla. La forma más intuitiva sería guardar cada reserva como un rango de fechas y comprobar si el rango que pide el usuario se solapa con alguno de los que ya existen. Genera pocas filas y es fácil de entender, pero bajo concurrencia es un problema bastante difícil, ya que comprobar un solapamiento obliga a leer todas las reservas del rango antes de decidir, y protegerlo requiere bloquear filas que todavía no existen.
La alternativa que voy a usar es descomponer la disponibilidad en unidades mínimas, es decir, una fila por cada tipo de habitación y cada noche, guardando cuántas unidades existen en total y cuántas están reservadas:
CREATE TABLE inventory (
  room_type_id   UUID NOT NULL,
  date           DATE NOT NULL,
  total_units    INT  NOT NULL,
  reserved_units INT  NOT NULL DEFAULT 0,
  PRIMARY KEY (room_type_id, date),
  CONSTRAINT no_overbooking
    CHECK (reserved_units >= 0 AND reserved_units <= total_units)
);
Estas filas no se crean al reservar, se cargan por adelantado cuando el administrador da de alta un tipo de habitación, y un proceso diario va extendiendo la ventana para que siempre haya un año disponible hacia adelante. Esto genera bastantes filas, alrededor de mil ochocientas por hotel con cinco tipos de habitación y un año cargado, pero a cambio convierte el problema en algo mucho más manejable, ya que reservar deja de ser comprobar un solapamiento y pasa a ser incrementar un contador sin superar un límite.
Y es importante que la fila exista antes de que llegue la primera reserva, porque esa fila es el punto por el que van a competir todas las peticiones de esa noche. Si dos usuarios tuvieran que crearla a la vez volveríamos a tener exactamente la misma carrera que estamos intentando evitar.
Teniendo el inventario representado de esta forma, reservar se resuelve en una sola instrucción:
UPDATE inventory
SET    reserved_units = reserved_units + :units
WHERE  room_type_id = :roomTypeId
  AND  date = :date
  AND  reserved_units + :units <= total_units;
Esta consulta se ejecuta una vez por cada noche de la estancia, todas dentro de una misma transacción. Si alguna de ellas devuelve cero filas afectadas significa que esa noche ya no tiene disponibilidad, por lo que se deshace la transacción completa y se le responde al usuario que no quedan habitaciones.
La diferencia con la versión anterior es que aquí no hay separación entre leer y escribir, la condición y la actualización ocurren en la misma operación atómica, y PostgreSQL se encarga de que dos transacciones no puedan modificar la misma fila a la vez. La segunda espera a que la primera termine y vuelve a evaluar la condición con el valor ya actualizado, así que si la primera agotó la última unidad, la segunda simplemente no cumple la condición y no modifica nada.
Esto es lo que hace que la solución sirva en producción. Si la protección estuviera en el código del microservicio, con un bloqueo en memoria o una variable, funcionaría con una sola instancia y dejaría de funcionar al levantar la segunda, porque cada proceso tiene su propia memoria y ninguno sabe lo que hace el otro. Y levantar réplicas es justo lo que hay que hacer cuando sube el tráfico. Al estar la garantía en la base de datos da igual cuántas instancias haya: todas compiten por la misma fila, y esa fila solo la puede modificar una a la vez.
La restricción CHECK de la tabla cumple aquí un papel distinto al que parece. No está para validar datos, está como última línea de defensa: aunque hubiera un error en el código, o alguien ejecutara una consulta a mano, la base de datos rechazaría cualquier fila donde las unidades reservadas superen las totales. Es la única garantía que sigue en pie cuando todo lo demás falla.
Ahora bien, resolver el problema en la base de datos garantiza que no haya dobles reservas, pero no dice nada sobre lo que ve el usuario, y eso también hay que diseñarlo. Con esta estrategia las peticiones que pierden la carrera no fallan. No hay excepción ni transacción abortada, simplemente el UPDATE no encuentra ninguna fila que cumpla la condición y actualiza cero filas, así que no hay nada que reintentar. El servicio traduce eso a una respuesta que dice que no quedan habitaciones, que es exactamente lo que el usuario necesita saber para probar otras fechas. Lo que sí hay que cuidar es que ese caso no se confunda nunca con un error del sistema: al que pierde la carrera hay que decirle que no hay disponibilidad, no devolverle un error interno, porque eso le diría que la aplicación está rota cuando en realidad está funcionando exactamente como debe.
La habitación mientras se paga
Hasta aquí he hablado de reservar como si fuera una sola operación, pero con pagos de por medio no lo es. Entre que el usuario pulsa el botón y el dinero llega pasan varios minutos, y hay que decidir qué pasa con la habitación durante ese tiempo.
Esperar al pago para tomar el inventario no funciona: dos personas llegarían a la pasarela por la última habitación y una pagaría algo que ya no existe. Dejarlo tomado para siempre tampoco, porque la mayoría de las reservas que se empiezan no se terminan.
Lo que hago es tomar el inventario en cuanto el usuario confirma las fechas, y crear la reserva en un estado intermedio, held, que caduca a los quince minutos. La habitación es suya mientras paga, y quien no consigue el hold se entera antes de llegar al pago.
Por eso existe el hold: el cobro ocurre fuera de la transacción. Si llamara a la pasarela con una transacción abierta, la fila del inventario quedaría bloqueada todo lo que el usuario tarde en pagar. Con el hold, la transacción dura milisegundos y el pago ocurre después.
El problema inverso son las reservas abandonadas. Un proceso cada treinta segundos expira los holds caducados y devuelve el inventario. Y libera igual que en el inventario: el estado esperado va dentro de la condición de la actualización, así que si el pago confirmó la reserva mientras tanto, no se afecta ninguna fila y el inventario no se libera.
El pago que llega tarde
Hay un caso menos evidente. El usuario tarda dieciséis minutos en pagar. El hold caduca, el proceso de limpieza libera el inventario, y entonces llega la confirmación del pago.
Hay dinero cobrado y una reserva expirada. Quedarse el dinero sin dar la habitación no es una opción. Pero confirmar sin más tampoco funciona: durante el minuto que el inventario estuvo libre pudo entrar otro cliente, y si confirmo sin comprobarlo creo la doble reserva que todo el sistema evita.
Lo que hago es intentar recuperarlo, noche a noche, con el mismo UPDATE condicional. Si todas las noches siguen teniendo sitio, la reserva se confirma y el cliente no se entera de nada. Si alguna falla, se deshacen las noches ya recuperadas y se emite un reembolso automático.
En los dos casos el resultado es correcto: el sistema nunca se queda con dinero de una reserva que no puede dar, ni confirma una habitación que ya no tiene.
Que el evento no se pierda
Esta parte no va de concurrencia sino de comunicación entre servicios.
Al confirmar una reserva hay que hacer dos cosas: cambiar su estado y avisar a los demás servicios. Son dos sistemas distintos, la base de datos y el broker, y no se pueden escribir de forma atómica. Si confirmo y luego falla la publicación, nadie se entera. Si publico primero y la transacción se deshace, se envía el correo de una reserva que no existe.
La solución es no publicar directamente. El evento se escribe en una tabla de la misma base de datos, dentro de la misma transacción, así que o se guardan las dos cosas o ninguna. Un proceso aparte lee esa tabla y publica lo pendiente. Si falla a mitad, el evento sigue ahí y se reintenta.
Lo peor que puede pasar entonces es que un evento se publique dos veces, y eso va a ocurrir de todas formas: un broker garantiza entrega al menos una vez, no exactamente una vez. Así que cada evento procesado deja su identificador como clave primaria en una tabla, insertándolo en la misma transacción que el trabajo. Si ya estaba, la inserción viola la clave, la transacción se deshace entera y el duplicado no tiene efecto. La deduplicación la hace un índice único, no una comprobación previa que podría tener su propia carrera.
El mismo patrón en cuatro sitios
La misma idea aparece en cuatro sitios: al reservar inventario, al expirar un hold, al recuperar un pago tardío y al reclamar eventos pendientes. Siempre lo mismo: en vez de leer, decidir en el código y escribir, la condición va dentro de la escritura y es la base de datos la que decide quién gana.
Puedes verlo funcionando
El sistema está desplegado en stays.joel-uzcategui.com. Se puede buscar, reservar y pagar con una tarjeta de prueba.
Y el código está en GitHub, repartido en dos repositorios:
- stays-launcher — el orquestador. No tiene código de aplicación: contiene el docker-compose, la infraestructura de desarrollo y los submódulos que apuntan al repositorio de cada microservicio.
- stays-web — el frontend, hecho en Next.js.